人工智能旅游推荐的心理评估:程序正义、感知自主性和游客信任
📝 英文题目:Psychological appraisals of AI tourism recommendations: Procedural justice, perceived autonomy, and tourist trust
📚 来源期刊:International Journal of Tourism Research
🗓 发表时间:2026-10
✍ 作者:Wenping Zhang, Lin Li, Bing Li, Zhangxiang Gao, Runcong Yang
🏆 期刊等级:SSCI Q1 · JCR Q1 · 中科院 管理学3区 · Scopus
“
你在旅游 App 上刷到一家「为你推荐」的酒店,凭什么敢信它?这篇发在 International Journal of Tourism Research 上的论文,用 503 名有旅游平台推荐功能使用经验的用户,把这个问题拆成了两条心理通路:一条叫程序公正——「推荐流程对我公平吗」;另一条叫感知自主——「最终决定还是我说了算吗」。结果很对称:透明度对公正感贡献最大(β=0.355),可控权对自主感贡献最大(β=0.288)。还有一个扎眼的调节发现:AI 素养越高的人,这三样设计特征对他心理评估的正向影响越强——同样的功能,懂 AI 的人「吃到」的效果比不懂的人大得多。
—— 扣子论文带读
📌 本文看点
01
AI素养
02
AI旅游推荐
03
可解释性
BACKGROUND
研究背景
问题提出
数字旅游时代,推荐系统已经成为旅游平台连接游客与目的地、住宿、景点等服务的核心界面:OTA 平台的酒店推荐、文旅应用的景点建议,AI 推荐深度参与游客的信息搜索与决策。但推荐系统越复杂,运行逻辑越不可见,用户依赖它的意愿就可能被削弱。这个问题在旅游情境里格外尖锐——旅游决策往往涉及陌生的目的地、大额的金钱与时间投入,以及消费前无法完整评估的体验型结果。所以游客关心的不只是「推荐结果准不准」,还有「这个过程能不能看懂、是否公平、是否尊重我自己的偏好」。这些评估,很可能就是信任的来源。
难点剖析
作者点出三个研究缺口。第一,既有研究没有充分区分「程序公正」和「感知自主」这两种不同的心理反应——前者关心推荐流程是否公平、一致、重视我的输入,后者关心我是否还觉得自己是旅游决策的作者。把它们捏成一个笼统的「好感」可能掩盖不同的心理通路。第二,游客理解和评估 AI 生成信息的能力差异很大:AI 素养可能决定用户能不能读懂解释、评估披露的信息、明白控制功能到底改变了什么,但 AI 素养是否改变「推荐特征 → 心理评估」之间的关系,几乎没有被检验过。第三,大部分证据来自一般信息系统或电商情境,而旅游推荐有独特条件——目的地陌生、感知不确定性高、体验型消费、下单后不可逆——这些特征会放大游客对公正感、可理解性和决策自主的敏感度,直接套用一般平台结论可能漏掉关键东西。
理论脉络
模型叠了两个经典理论。程序公正理论(Colquitt, 2001)解释评估性通路:人不仅看结果,还看流程是否一致、无偏、可纠正、重视自己的利益——可解释性提供可评估的理由、透明度让过程可见、可控性给了表达偏好的机会,三者分别对应公正程序的不同侧面(说明理由、过程可见、考虑输入)。自我决定理论(Deci & Ryan, 2000)解释能动性通路:当行为是自愿的、自我认可的、与个人意图一致时,人体验到自主;解释与透明提供信息支持、可控性提供行为干预机会,都可能与「这是我自己的决定」的体验相关。技术信任研究(Gefen 等,2003)则说明用户对系统可靠性、能力与响应性的判断决定其依赖意愿。另外作者明确一点:三个特征测的都是游客的主观感知,不是客观观测或实验操纵的平台功能。
METHOD
研究方法
理论模型
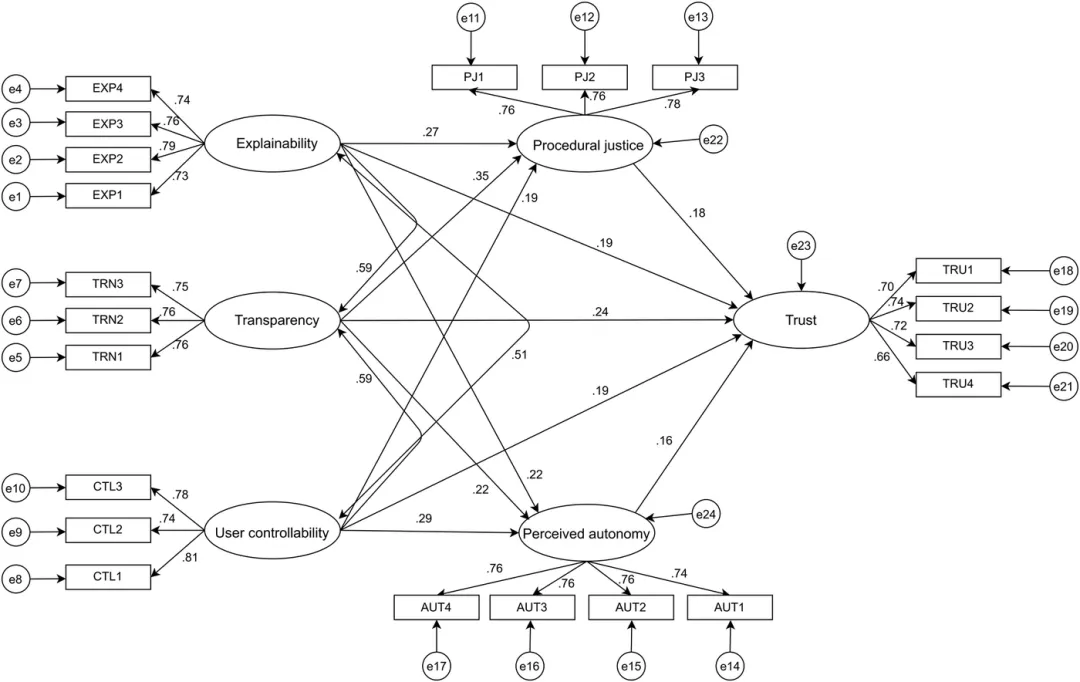
双通路模型。三个推荐特征——可解释性(EXP,能不能明白为什么推荐这个)、透明度(TRN,能不能看见数据来源与决策标准)、用户可控性(CTL,能不能改偏好、加筛选、给反馈、否掉不合适的推荐)——各自通向两个心理中介:程序公正(PJ)与感知自主(AUT);两个中介再通向对 AI 旅游推荐的信任(TRU);同时保留三条特征到信任的直接路径以判断中介类型。AI 素养(AIL)调节六个第一阶段的「特征 → 心理评估」关系。共 18 条假设(H1a–H1c、H2a–H2c 直接效应,H3–H4 心理变量到信任,H5a–H5c 与 H6a–H6c 两条中介,H7a–H7c 与 H8a–H8c 六条调节)。
研究假设
共十八条。H1a–H1c,可解释性、透明度、可控性各自正向关联程序公正;H2a–H2c,三者各自正向关联感知自主;H3,程序公正正向关联信任;H4,感知自主正向关联信任;H5a–H5c,三个特征到信任的正向关联经程序公正统计中介;H6a–H6c,经感知自主统计中介;H7a–H7c,AI 素养正向调节「特征 → 程序公正」三条关系(素养越高关系越强);H8a–H8c,AI 素养正向调节「特征 → 感知自主」三条关系。18 条全部获得支持。
分析策略
横断面单波问卷。分析分四步:先做验证性因子分析评估测量性质(信度、CR、AVE);再做结构方程模型估计六个构念与信任之间的关联;间接效应用 Bootstrap(5000 次)检验置信区间;AI 素养的调节作用单独用层级回归检验(控制性别、年龄、学历),连续预测变量与 AI 素养先做均值中心化再构建交互项,用交互系数与增量解释力 ΔR² 评估。多重共线性用 VIF 与容忍度诊断。作者在方法部分反复强调:所有变量都是横断面自评,估计出的路径应解读为「理论上有序的关联」而非因果链。
DESIGN
实验设计
数据收集
576 份问卷发放,按预设质量标准清洗:作答时间短于 3 分钟、所有量表题全选同一选项、存在明显逻辑不一致的都剔除,最终保留 503 份有效问卷,可用率 87.3%。招募用便利抽样与滚雪球抽样,渠道包括在线调查平台、社交媒体、高校社群与行业相关社群——目的是提升年龄、教育、旅行经验与平台使用习惯上的异质性;作者明确承认这是非概率抽样,样本不能当作全体旅游平台用户的统计代表。所有受访者均为 18 岁及以上、有旅游平台推荐功能使用经验。研究获中国地质大学(北京)学术委员会伦理批准,参与者知情同意、自愿作答、可随时退出。一个背景细节:投稿 2026-07-31、修回 2026-10-02、录用 2026-10-13,从投稿到录用约十周。
研究样本
最终样本 503 人。性别较均衡:男 271(53.88%)、女 232(46.12%)。年龄分布少见地铺得很开:18–25 岁 20.28%、26–35 岁 17.50%、36–45 岁 19.09%、46–55 岁 19.28%、56–65 岁 18.69%、65 岁以上 5.17%——中老年用户占了近四成,这在 AI 采纳类问卷里不多见。学历偏高:本科 22.86%、硕士 21.67%、博士 11.73%(合计 56.3%),但也有高中及以下 24.25%、大专 19.48%。过去一年旅行频率:6–10 次 28.83%、10 次以上 24.25%;平台使用频率:每周多次及以上合计约 37.4%,但也有 14.91% 几乎不用。
测量工具
问卷三部分:研究目的与知情说明、人口学与使用信息、核心构念测量——七个构念共 25 题,全部改编自成熟量表并针对 AI 旅游推荐情境化:可解释性 4 题(Barredo Arrieta 等 2020)、透明度 3 题(Durcikova & Gray 2009;Pei 等 2024)、用户可控性 3 题(Bala & Venkatesh 2016;Elie-Dit-Cosaque & Straub 2011)、程序公正 3 题(Gacto 等 2011)、感知自主 4 题(Deci & Ryan 2000;Gan 2017;Standage 等 2005;Wang & Benbasat 2007)、信任 4 题(Gefen 等 2003)、AI 素养 4 题(Long & Magerko 2020;Zhong 等 2024)。全部采用七点李克特(1 非常不同意,7 非常同意)。初始问卷先由三位分别有 AI 用户行为、旅游研究、量表开发经验的专家审阅修改表述,再走预调查检验题项清晰度,然后才正式发放。
RESULTS
结果与分析
信效度检验
测量模型过关。七个构念 Cronbach‘s α 介于 0.800 到 0.841,CR 介于 0.801 到 0.842;标准化载荷 0.663 到 0.807——唯一低于 0.70 的是信任量表的 TRU4(0.663),但整体达标;AVE 介于 0.503 到 0.602,全部跨过 0.50 门槛(信任 0.503 是最贴线的那个)。区分效度用 Fornell–Larcker 准则:各构念 AVE 平方根 0.709–0.776,均大于其与其他构念的相关——最大的构念间相关是透明度与信任的 r=0.655,仍低于透明度(0.757)与信任(0.709)的对角线值。结构模型拟合良好:χ²/df=1.691、CFI=0.974、TLI=0.969、NFI=0.940、RMSEA=0.037、GFI=0.948、AGFI=0.931。构念均值在 4.137–4.333(7 点量表),各构念两两相关 0.362–0.526,中等强度、无严重冗余迹象。方法上有一点要指出:全文没有报告 Harman 单因子检验或其他共同方法偏差检验,作者只在局限里承认单波自评可能引入共同方法偏差与响应一致性问题。
假设检验
H1a–H1c 成立(通往程序公正):透明度最大 β=0.355(p<0.001),可解释性 β=0.269(p<0.001),可控性 β=0.186(p=0.003)。注意作者自己的提醒:没做系数差异检验,这个排序只能作描述性解读。
H2a–H2c 成立(通往感知自主):可控性最大 β=0.288(p<0.001),透明度 β=0.220(p=0.002)与可解释性 β=0.219(p<0.001)接近。
H3 成立:程序公正 → 信任 β=0.175(p=0.007)。H4 成立:感知自主 → 信任 β=0.162(p=0.004)。
直接路径:透明度 → 信任 β=0.243(p<0.001)、可解释性 → 信任 β=0.193(p=0.002)、可控性 → 信任 β=0.187(p=0.003)——三个直接效应在放入两个中介后仍然显著,总体模式符合部分中介而非完全中介。
Bootstrap 间接效应(经程序公正):透明度 0.062(95% CI [0.016, 0.134],p=0.009)最大,可解释性 0.047([0.011, 0.101])、可控性 0.033([0.005, 0.085]),H5a–H5c 成立。经感知自主:可控性 0.047([0.016, 0.105],p=0.002)最大,可解释性与透明度均为 0.036,H6a–H6c 成立。
AI 素养的六条调节全部成立:程序公正侧 EXP×AIL β=0.189(ΔR²=0.034)、TRN×AIL β=0.242(ΔR²=0.057,六个里最大)、CTL×AIL β=0.197(ΔR²=0.038);感知自主侧 EXP×AIL β=0.196(ΔR²=0.037)、TRN×AIL β=0.227(ΔR²=0.050)、CTL×AIL β=0.212(ΔR²=0.044),全部 p<0.001。
简单斜率(±1SD):透明度 → 程序公正的斜率从低素养的 B=0.188 升到高素养的 B=0.632(差值 0.443,六组里最大);可控性 → 程序公正从 0.138 到 0.494;可解释性 → 感知自主从 0.154 到 0.466。六组斜率无一例外在高素养侧更陡。
CONCLUSION
总体结论
研究结论
四层结论。第一,程序公正与感知自主是两条互补而非可互换的通路:游客信任推荐系统,可能因为流程显得合法公正,可能因为觉得决定权还在自己手里,也可能两者都有。把它们分开建模,比笼统的「好感」解释力强得多。第二,三个特征的角色分工很清楚:透明度是公正感的头号原料(用户无法直接观测算法是否公平,只能靠看得见的推荐标准、数据使用、决策逻辑来评估),可控权是自主感的头号原料(能改偏好、拒绝不合适的建议,才保得住「决定是我的」这种所有权),可解释性两头都沾、但哪头都不是最大。第三,AI 素养是边界条件,不是加分项:六条「特征 → 心理评估」的关系全部在高素养人群里更陡——同样一套设计,懂 AI 的人能把它翻译成更强的公正感与自主感,不懂的人吃不到。但作者特别提醒:这不等于 AI 素养一定推高信任,懂行的人也更可能发现解释不完整、算法有偏、商业推销的痕迹。第四,实践上四条可操作建议:透明度信息要简洁、结构化、面向用户,而不是堆长篇技术披露(过载反而加重认知负担);解释要贴合具体决策——「推荐这家酒店因为它符合你的预算和位置偏好」远比「为你推荐」有心理价值;控制功能必须产生看得见的结果变化,让用户明白自己的操作和系统响应之间的联系;针对 AI 素养差异做分层解释界面——基础层给短说明,进阶层给排序逻辑、数据使用与推荐不确定性的详细信息。
研究局限
作者列了四条,都很实在。其一,横断面设计无法确立时间或因果顺序——本来就信任平台的人,可能对其推荐特征、公正感、自主感的评价都更正面;作者建议纵向或多波设计。其二,全部变量来自单一自评问卷,可能引入共同方法偏差与响应一致性效应,作者建议分时点测量或结合行为记录——值得注意的是全文没报告任何 CMB 统计检验。其三,可解释性、透明度、可控性测的是主观感知,不是客观观测或实验操纵的系统特征,受控界面实验才能给出更硬的设计效应证据。其四,便利与滚雪球抽样限制了代表性,且自评的信任未必对应真实的推荐采纳、下单、持续使用等行为。补充两点方法观察:其一,三个特征到心理变量的系数排序(谁比谁大)作者没做正式的系数差异检验,只能描述性读;其二,信任量表 TRU4 载荷 0.663、AVE 0.503,是测量上最弱的一环。另外样本的博士占比 11.73%、硕士以上合计超过三分之一,教育水平明显高于大众用户群体。
未来展望
作者建议:改用纵向或多波设计追踪这些感知如何随时间发展,厘清「信任 → 更正面评价」的反向路径;把预测变量与结果变量的测量分置不同时点,或结合行为记录(推荐采纳、下单、持续使用)替代纯自评;用受控界面实验操纵可解释性、透明度与可控性的具体设计,检验真实的设计效应;讨论部分还点名了几个未纳入模型的可能相关因素——感知推荐准确性、有用性、不确定性、隐私顾虑、感知操纵感,都可以作为下一轮扩展的方向。另外作者刻意避免把 AI 素养解读为结构性不平等的证据,而把它定位为「解释性能力」,这个立场也留了空间给后续研究去检验数字鸿沟视角。
金句
同样的推荐功能,懂 AI 的人吃到的公正感和自主感更强——信任不是被设计出来的,是被「看懂」出来的。
— 研究模型图
📄 摘要原文
This study develops a dual-path model to examine how explainability, transparency, and user controllability are associated with trust in AI-powered tourism recommendations through procedural justice and perceived autonomy. AI literacy is further examined as a moderator of the relationships between the three recommendation characteristics and the two psychological variables. The results show that explainability, transparency, and user controllability are positively associated with both procedural justice and perceived autonomy. Transparency has the largest estimated association with procedural justice, whereas user controllability has the strongest estimated association with perceived autonomy. Both psychological variables are positively associated with trust and provide significant indirect pathways between the three recommendation characteristics and trust, indicating partial mediation. AI literacy positively moderates all six associations, with consistently steeper positive slopes among respondents reporting higher AI literacy. These findings distinguish procedural fairness evaluation from decision autonomy as two complementary psychological pathways related to tourist trust.
📎 阅读原文:DOI: 10.1002/jtr.70434
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如需推广论文,请咨询WeChat:Q495428。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)
三连一下,不失联!
相关文章
发表评论
评论列表
- 这篇文章还没有收到评论,赶紧来抢沙发吧~